
 chibiham
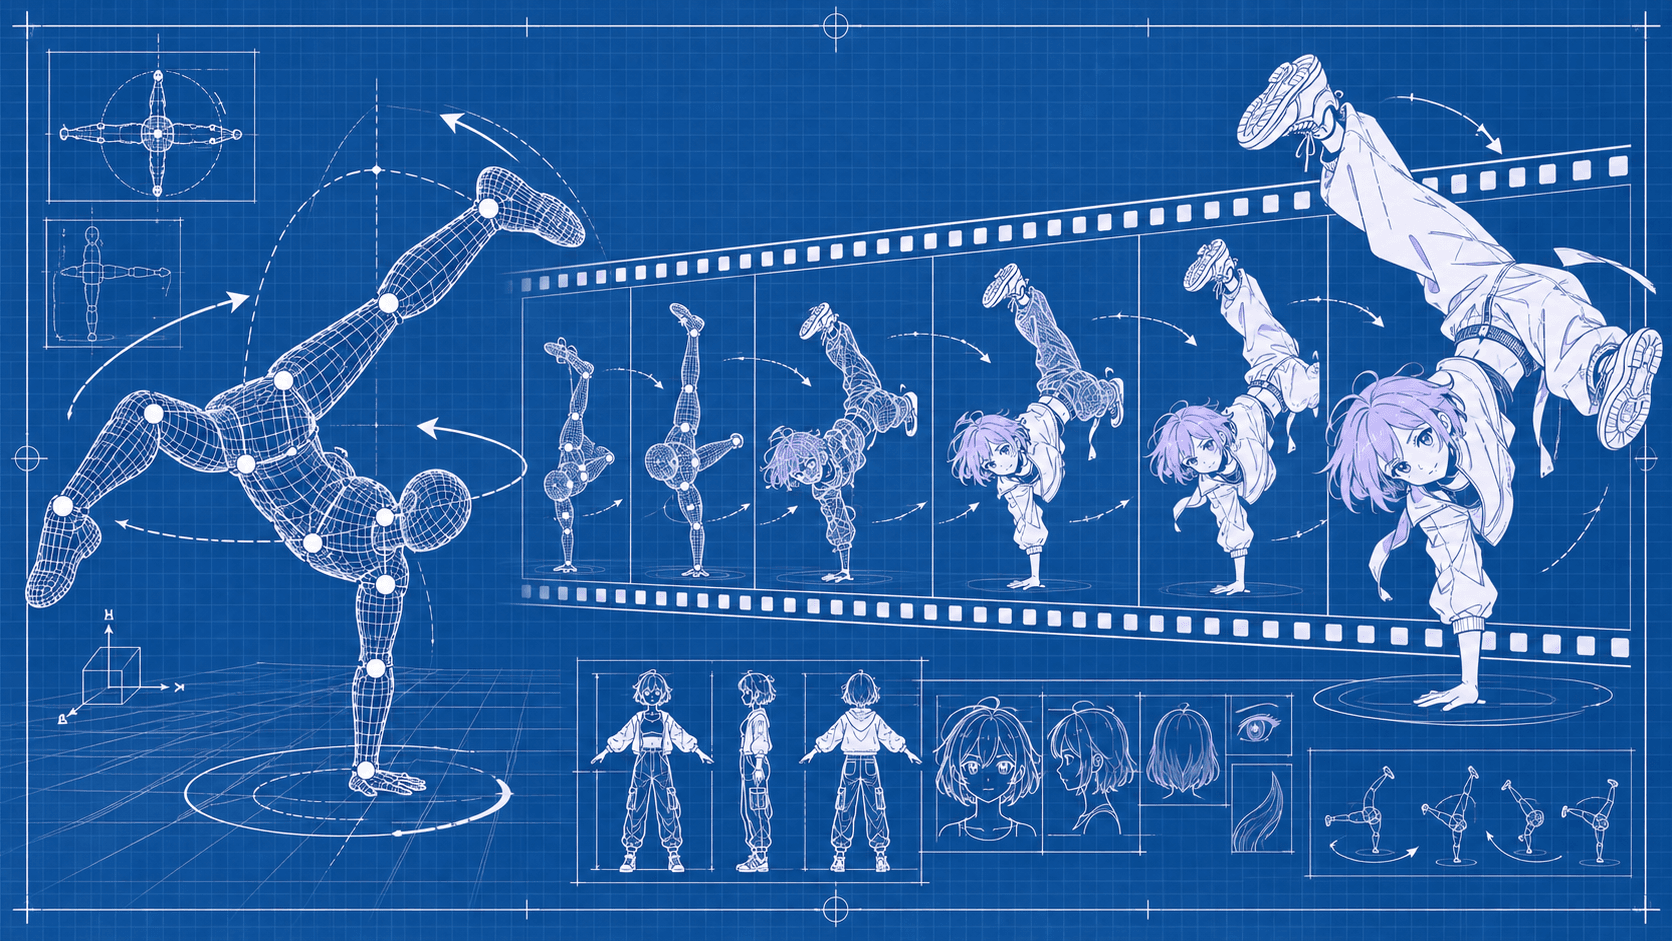
ChatGPTで描いた12コマのダンスの絵を、コマを増やしてモーションブラー付きのアニメーションにしたい。そんな軽い思いつきから始めて、3日ほどで自分のキャラクター(ちびはむちゃん)にブレイクダンスを踊らせるところまで来た。方式は15回近く作り直している。
結論を先に書くと、「動きは3Dの正確なデータで決め、絵だけを画像生成AIに描かせる」という分担はうまくいった。ただ、逆立ちや腕が顔にかかる姿勢は最後まで安定しなかった。画像生成AIには「顔を見せたがる」「普通の姿勢に戻したがる」という強い癖がある。
使った道具は、OpenAI Codex の画像生成、自宅の ComfyUI(Qwen-Image 2.1、MiniMax H3)、Mixamo のモーションキャプチャ、Blender、OpenCV と ポーズ推定、ffmpeg。オーケストレーションはすべて Claude Code との対話で行い、自分は結果を見て「微妙」「いい感じ」と言っていただけだ。
12コマの絵を動かす
最初は1枚のシートに24コマを描かせたが、1コマ256px程度ではつながりが分からない。次に1コマずつ描かせると動きはつながったが、頭の位置や大きさが毎回ずれてガタつく。後処理で軌跡をなめらかにすると、今度は足が滑った。本来どこに頭があるべきかを知らないまま、「なめらかであるべき」という思い込みで引っ張っていただけだった。
そこで役割を分けた。動きは動画生成AI(MiniMax H3)に下書きさせ、Codex が1コマずつアニメ絵に清書する。
ブラーは、動いていない部位にまで入ってしまった。そこで、部位ごとの動きを計算して、動いている部分を赤く塗り、方向の矢印を描いた「動きの地図」を渡した。指示は「赤い部分だけブラー、それ以外はくっきり」。
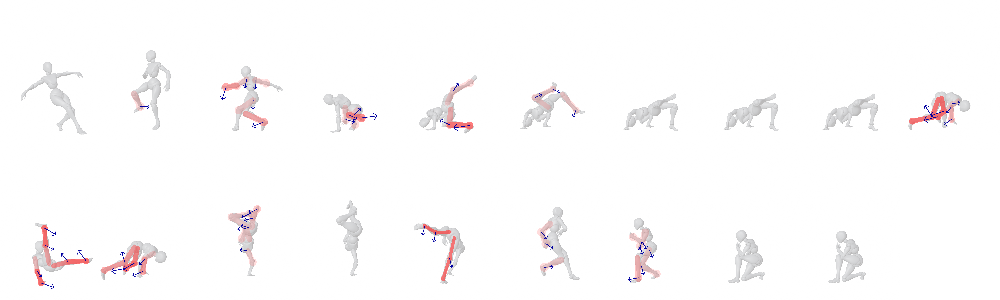 清書AIに渡した「動きの地図」。速く動いている手足だけが赤く塗られ、青い矢印で方向を示している(後述の Mixamo 版)
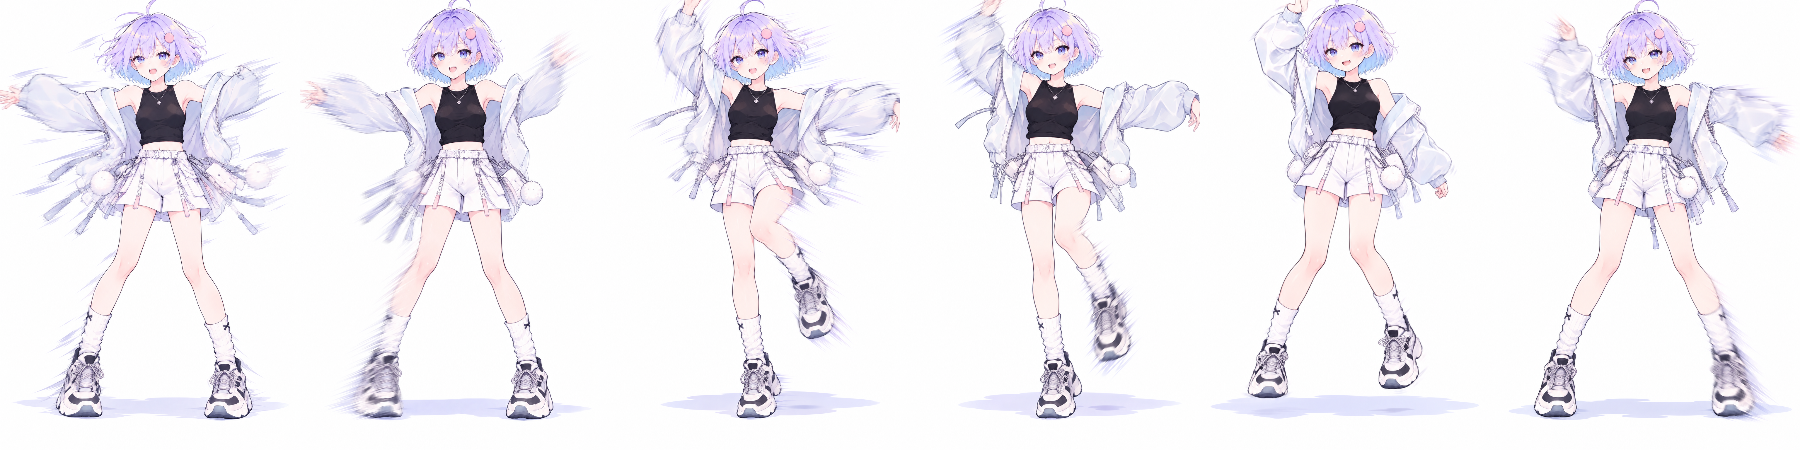 左が推測させた版、右が動きの地図を渡した版
本物の動きを下敷きにする
元の動きがそもそも遅かったので、実写のブレイクダンス動画を下敷きにした。ポーズ推定で全フレームの関節が取れるので、清書の位置を元動画の関節に合わせられる。今度は「正解」があるので、補正が素直に効いた。ただ、他人の投稿を使っているので外には出せない。
動画生成AIだけで踊らせる方法も試したが、ポーズ間をぬるっと変形させるだけで、回転技にならなかった。
最終的には Mixamo のモーションキャプチャ(無料で商用利用可)を Blender で4つつなぎ、約9.5秒のダンスにした。Blender からは全コマの正確な関節座標を書き出せる。動きの地図、姿勢の説明文、位置合わせ、崩れの検出が、すべて推定ではなく正確なデータで回るようになった。
コマ間の一貫性
ここからは「動きは正確、でも絵がコマごとにぶれる」問題との戦いだった。効いたのは次の3つ。
- 1つの Codex セッションで全コマを順に描かせる:それまでは1コマごとに新しいセッションを起動していた。同じセッションで続けて描かせると、前のコマを覚えたまま描けるので、大きさの1コマごとの変化が 15% から 6.6% に減った
- 部位ごとに色分けしたマネキン:灰色一色では、手足が重なると左右も前後も分からない。色分けして顔に目と鼻の印を付けると、手足の区別と顔の向きが伝わった
- グリッドの背景:白いキャンバスには大きさの基準がない。マス目の床と壁を描いて「この上に同じ大きさで描け」と指示すると、大きさのぶれが半分近くに減った
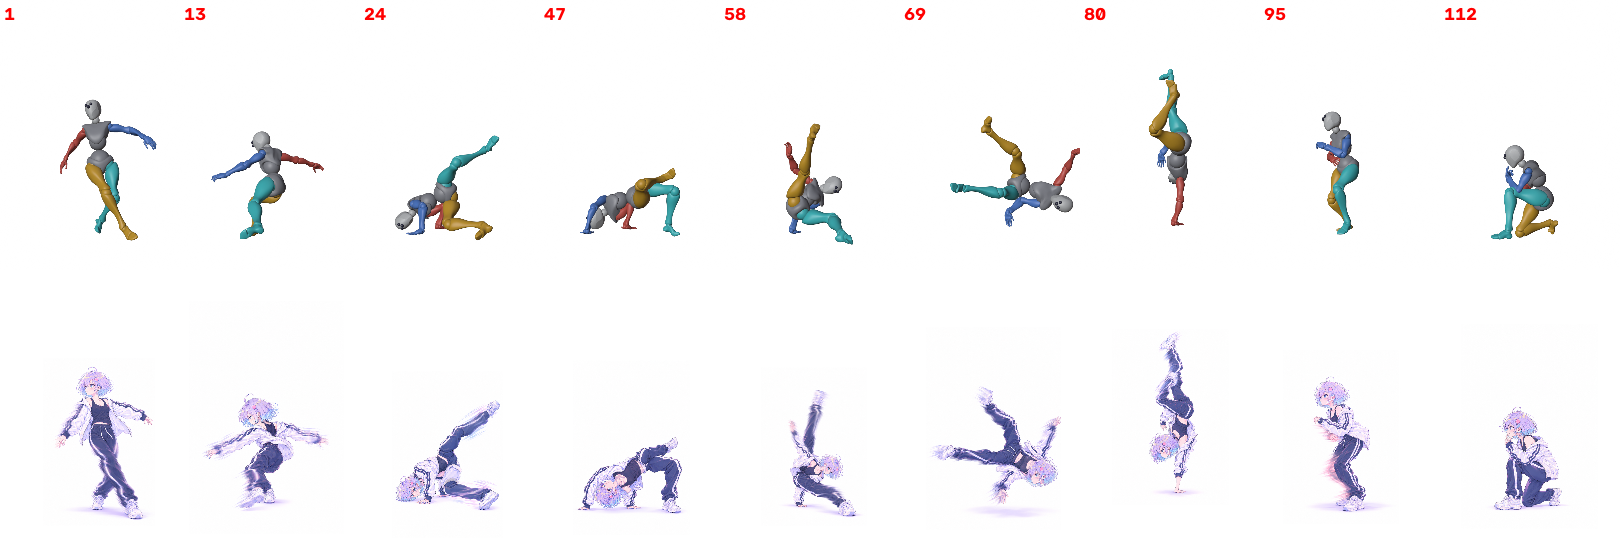 上が色分けマネキン、下が清書。数字はコマ番号
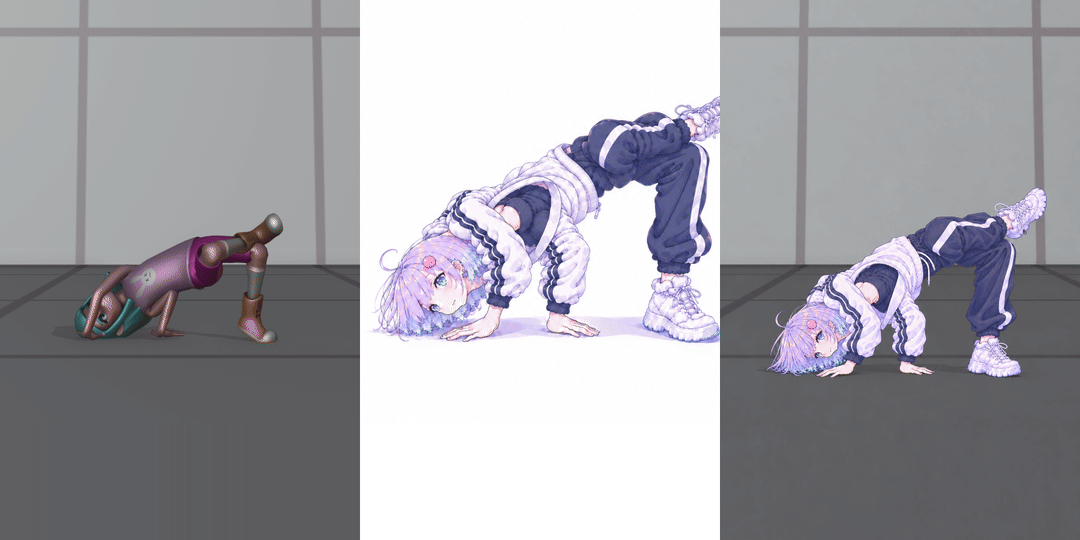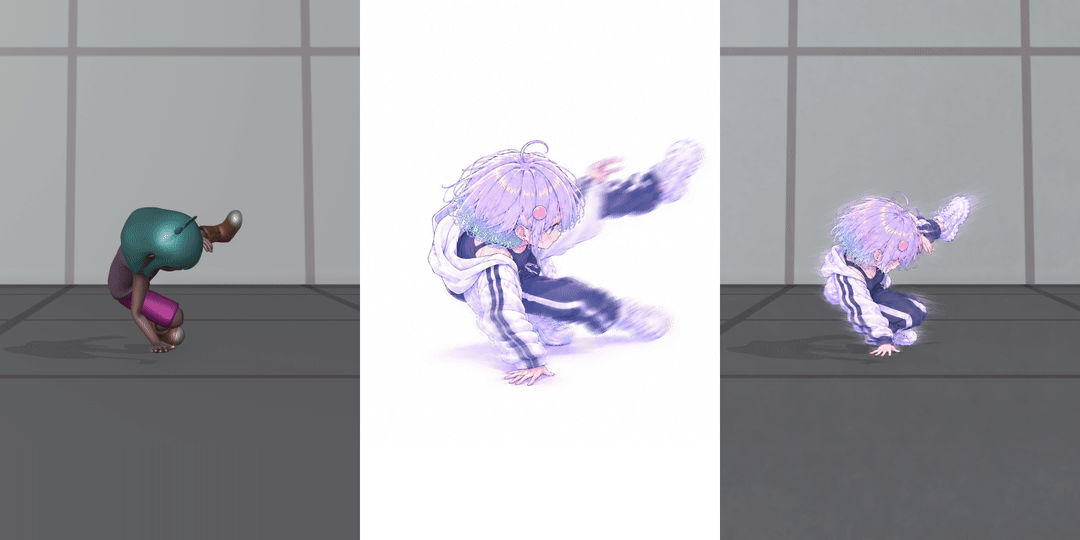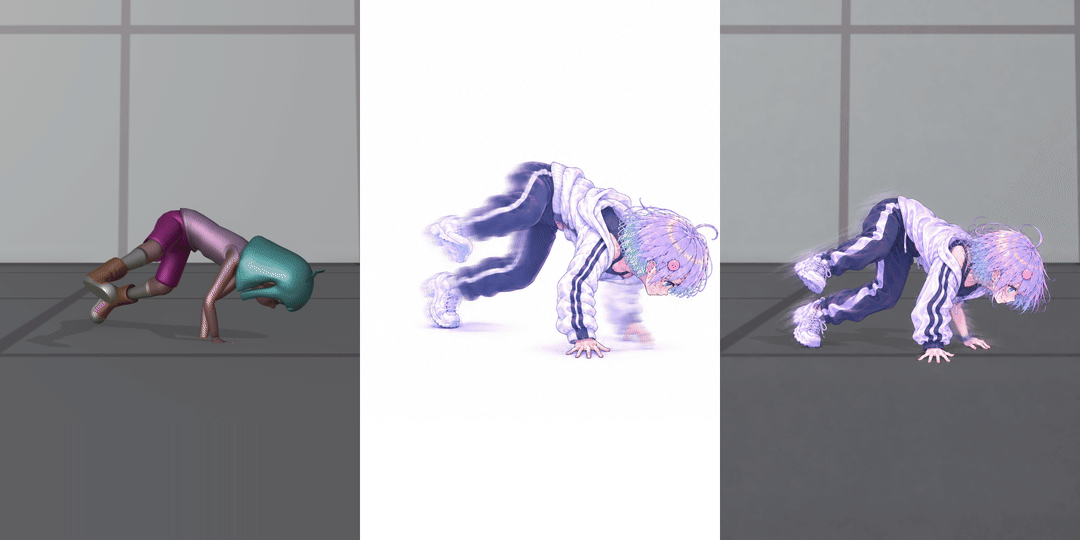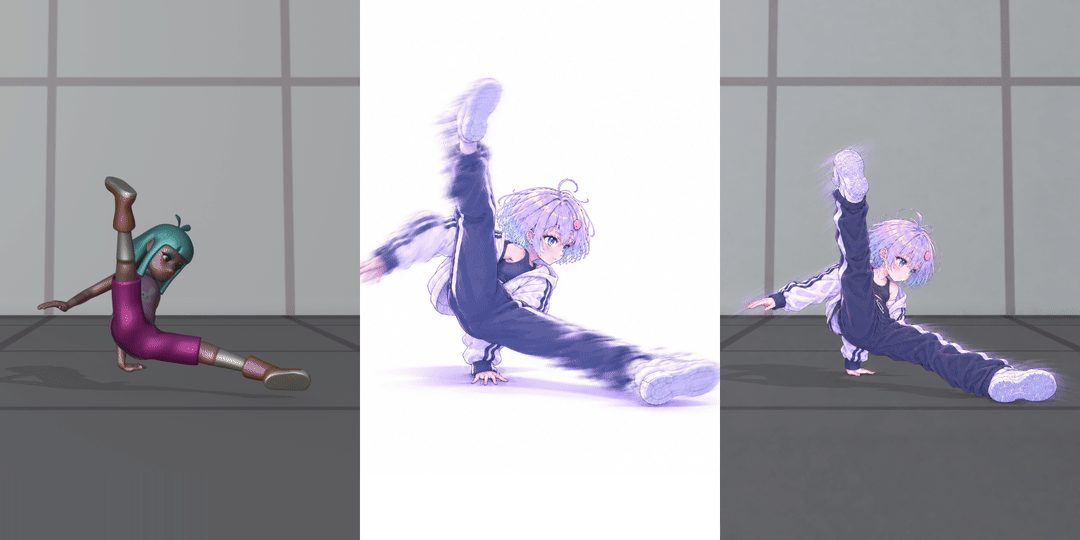 左から見本、白背景版、グリッド背景版
ローカルの Qwen-Image 2.1 も試した。img2img や ControlNet で大まかな姿勢は伝わるが、正確なポーズの固定では Codex を超えなかった。
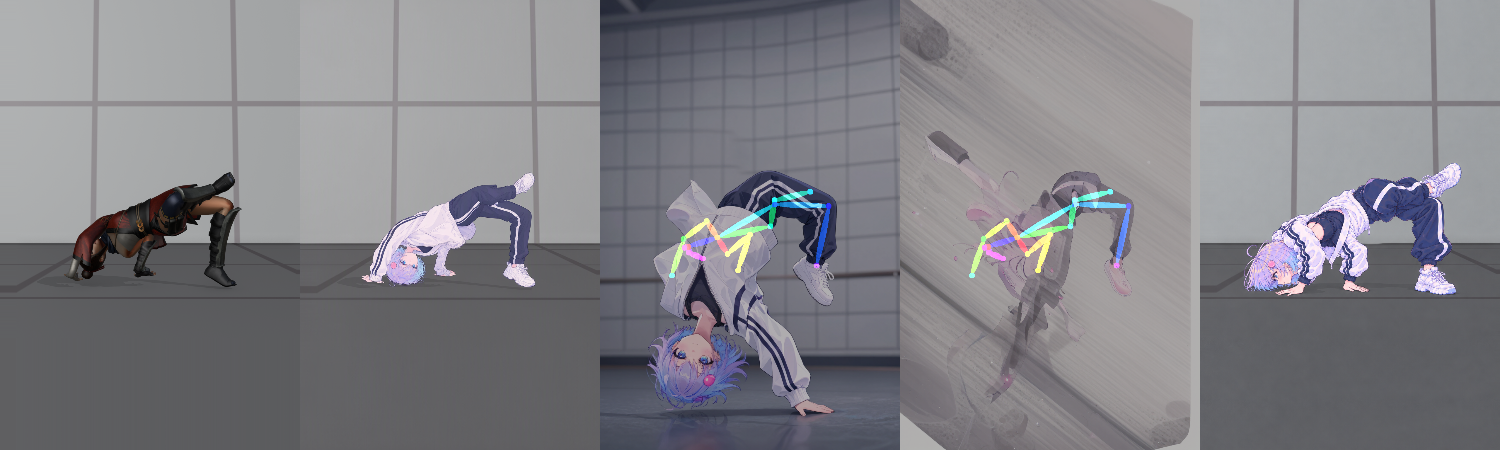 左から見本、Qwen img2img、Qwen+ControlNet(強さ 1.0、2.0)、Codex のグリッド版
わかったこと
生成AIには絵だけを任せる。 最初の失敗は、画像生成AIに「絵」と「動き」を同時に任せたことだった。動きを3Dデータに移し、生成AIの担当を絵に絞るのが一番安定した。
暗黙の推論を、明示的な入力に置き換える。 進展があったのはいつも、AIに推測させていた部分を入力に置き換えたときだった。どこが動くか→動きの地図、どの手足か→色分け、大きさ→グリッド、前に何を描いたか→同じセッションの文脈。絵コンテに矢印を書き込む演出家の仕事に近い。
補正は、正解があるときだけ効く。 同じ「拡大縮小と平行移動」でも、「なめらかであるべき」に合わせると失敗し、観測された関節に合わせると成功した。拘束条件なしの正則化と、境界条件つきの問題の違いだ。
事前分布の癖は、指示では直らない。 顔が床を向いていても、生成された絵はこちらに顔を向けようとする。逆さまの体は頭が上に戻る。学習データの大半が「こちらを向いて立つ人」なのだから当然だ。「顔を見せるな」と書いても効き目は薄い。
おわりに
進展はいつも、自分が「なんか変」と言ったところから始まった。その違和感を言葉にして、AIに推測させていた部分を一つずつ入力に置き換えていく作業だった。
最後に残った「顔を見せたがる癖」は、その置き換えでは届かない、モデルの事前分布そのものだった。どこまでを入力で縛れて、どこからがモデルの限界なのか。その境界線が見えたことが、この3日間の一番の収穫だった。